精修任务合批前,用 Python 找重复输入的任务ID要处理的不是商品效果,而是一类可以由程序明确判断的输入问题。以任务id作为身份,去掉id后比较剩余JSON定义。完全相同的定义可归为重复,不同定义使用同一id则报告冲突,不能任意选最后一条覆盖前一条。
精修任务合批前,用 Python 找重复输入的任务ID要处理的不是商品效果,而是一类可以由程序明确判断的输入问题。以任务id作为身份,去掉id后比较剩余JSON定义。完全相同的定义可归为重复,不同定义使用同一id则报告冲突,不能任意选最后一条覆盖前一条。
输入契约与实现
以任务id作为身份,去掉id后比较剩余JSON定义。完全相同的定义可归为重复,不同定义使用同一id则报告冲突,不能任意选最后一条覆盖前一条。
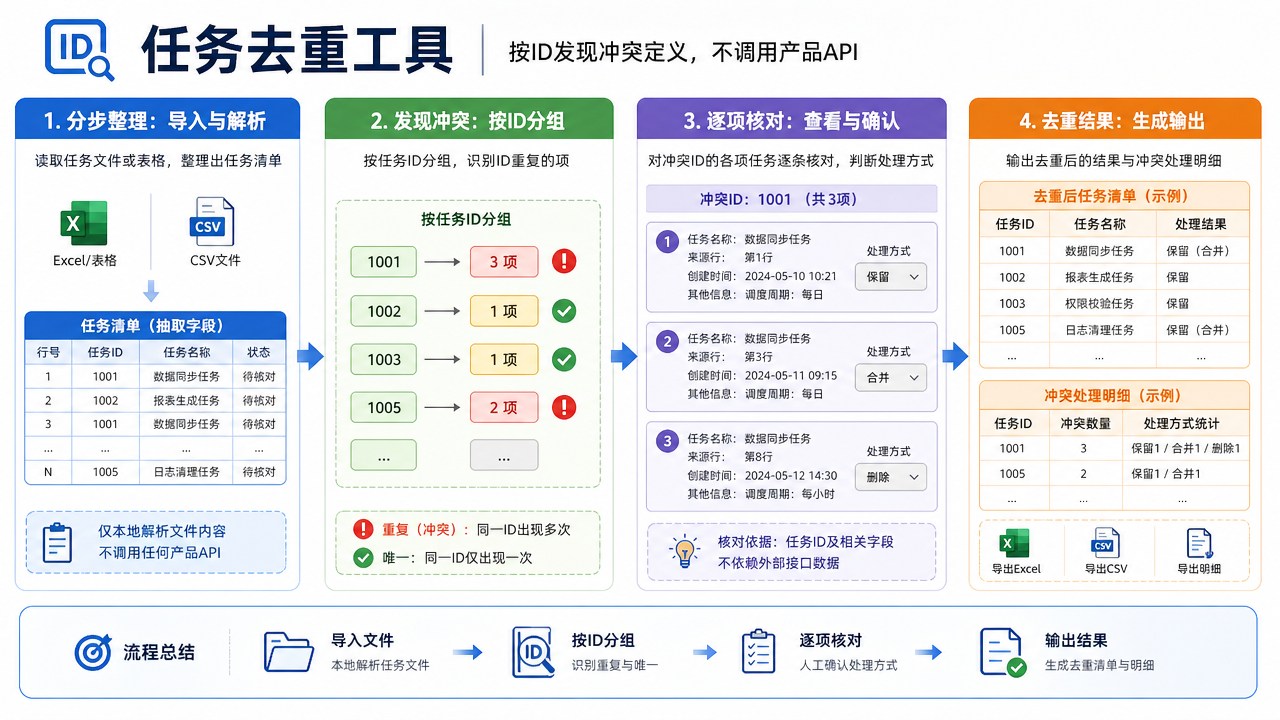
代码把任务ID冲突检查限定成小范围任务,刻意不增加网络请求、文件覆盖和发布动作。
运行结果与排错
两个不同id通过;重复定义进入duplicates;同id不同输入进入conflicts;缺id抛出invalid_id:0。
这里只做输入清单检查,不证明两张图片字节相同,也不推断Picset具备任务去重接口。修改结果必须由清单负责者确认。如果要扩大范围,先添加对应失败夹具,再修改实现。
成功分支同样要验证结果含义。
放在图片制作链路的哪里
这个工具适合放在任务去重工具相关的本地资料整理环节,和图像制作保持解耦。
实际交接至少保留输入版本、代码版本和完整报告。
本例的覆盖范围是:两个不同id通过;重复定义进入duplicates;同id不同输入进入conflicts;缺id抛出invalid_id:0。未覆盖的边界是:这里只做输入清单检查,不证明两张图片字节相同,也不推断Picset具备任务去重接口。修改结果必须由清单负责者确认。
import json
def check(tasks):
    seen, duplicates, conflicts = {}, [], []
    for index, task in enumerate(tasks):
        identity = task.get('id')
        if not isinstance(identity, str) or not identity.strip():
            raise ValueError('invalid_id:' + str(index))
        payload = {k: v for k, v in task.items() if k != 'id'}
        canonical = json.dumps(payload, sort_keys=True, ensure_ascii=False, allow_nan=False)
        if identity in seen:
            target = duplicates if seen[identity] == canonical else conflicts
            target.append(identity)
        else:
            seen[identity] = canonical
    return {'duplicates': duplicates, 'conflicts': conflicts}
good = [{'id': 't1', 'input': 'a.png'}, {'id': 't2', 'input': 'b.png'}]
bad = [good[0], dict(good[0]), {'id': 't1', 'input': 'c.png'}]
assert check(good) == {'duplicates': [], 'conflicts': []}
assert check(bad) == {'duplicates': ['t1'], 'conflicts': ['t1']}
try:
    check([{'input': 'a.png'}])
except ValueError as exc:
    assert str(exc) == 'invalid_id:0'
else:
    raise AssertionError('expected rejection')
print(json.dumps({'success': check(good), 'errors': check(bad)}))
编辑复核与下一组测试
任务合批时应先判断身份是否一致,再判断定义是否一致。本文用id作为身份,比较的是去掉id之后剩余的JSON定义,因此duplicates与conflicts不能合并成一个重复任务统计。duplicates表示同一身份对应相同定义,可以交给清单负责人确认是否只是重复录入;conflicts表示同一身份被用于不同输入,必须查清哪份定义属于本次任务,不能采用最后一条覆盖前一条的方式消除提示。阅读冲突报告时,宜把同id的各条记录并列展示,逐项核对剩余字段的差异和各自来源,而不是仅凭任务名称挑选一个看起来更新的版本。两个不同id通过这个成功例子也有边界:即使它们剩余定义相同,只要身份不同,也不能据此推定检查器会把它们归为同一任务,更不能据此决定取消其中一条。是否允许不同任务使用同一输入,需要另有业务规则。缺id抛出invalid_id:0时,应回到对应记录补齐身份或确认来源,而不是把这一行直接丢掉;没有身份就无法稳定归并,同样也不能随手填一个临时编号并宣称冲突已经解决。下一组测试可安排同一id出现三次,前两次定义一致、第三次不同,观察重复与冲突线索能否让维护者看清三条记录的关系;再交换录入顺序,检查报告是否会诱导调用方误把首条或末条当成已获批准的定义。还可以只改变剩余JSON中的一个字段,与完全相同定义形成对照,确认比较范围没有遗漏影响任务的输入。对于缺id以外的非法身份形式,应根据实际契约补充单独夹具,不应自行假设空格、数字和字符串能够互相转换。若两个定义指向同一个文件名,本工具仍没有比较图片字节;文件内容被替换而名字不变,也不能靠任务定义相同发现。它最适合用于不同人员整理的精修清单准备合并、尚未进入执行队列的节点,重点解决身份碰撞,不负责确认图像是否相同。交接结果应分别列出待确认的重复项和待裁定的冲突项,并保留被比较的原始定义,这样接收者能够解释为什么保留某条任务,而不是只拿到一份删过记录、却无法追溯取舍理由的清单。