用 Python 检查 SKU 图片顺序要处理的不是商品效果,而是一类可以由程序明确判断的输入问题。CSV中每行保持sku、role、position三个字符串字段。主图使用main角色,图位转换为正整数;同一SKU必须有且只有一张主图,主图的序号要小于细节图。
用 Python 检查 SKU 图片顺序要处理的不是商品效果,而是一类可以由程序明确判断的输入问题。CSV中每行保持sku、role、position三个字符串字段。主图使用main角色,图位转换为正整数;同一SKU必须有且只有一张主图,主图的序号要小于细节图。
输入契约与实现
CSV中每行保持sku、role、position三个字符串字段。主图使用main角色,图位转换为正整数;同一SKU必须有且只有一张主图,主图的序号要小于细节图。
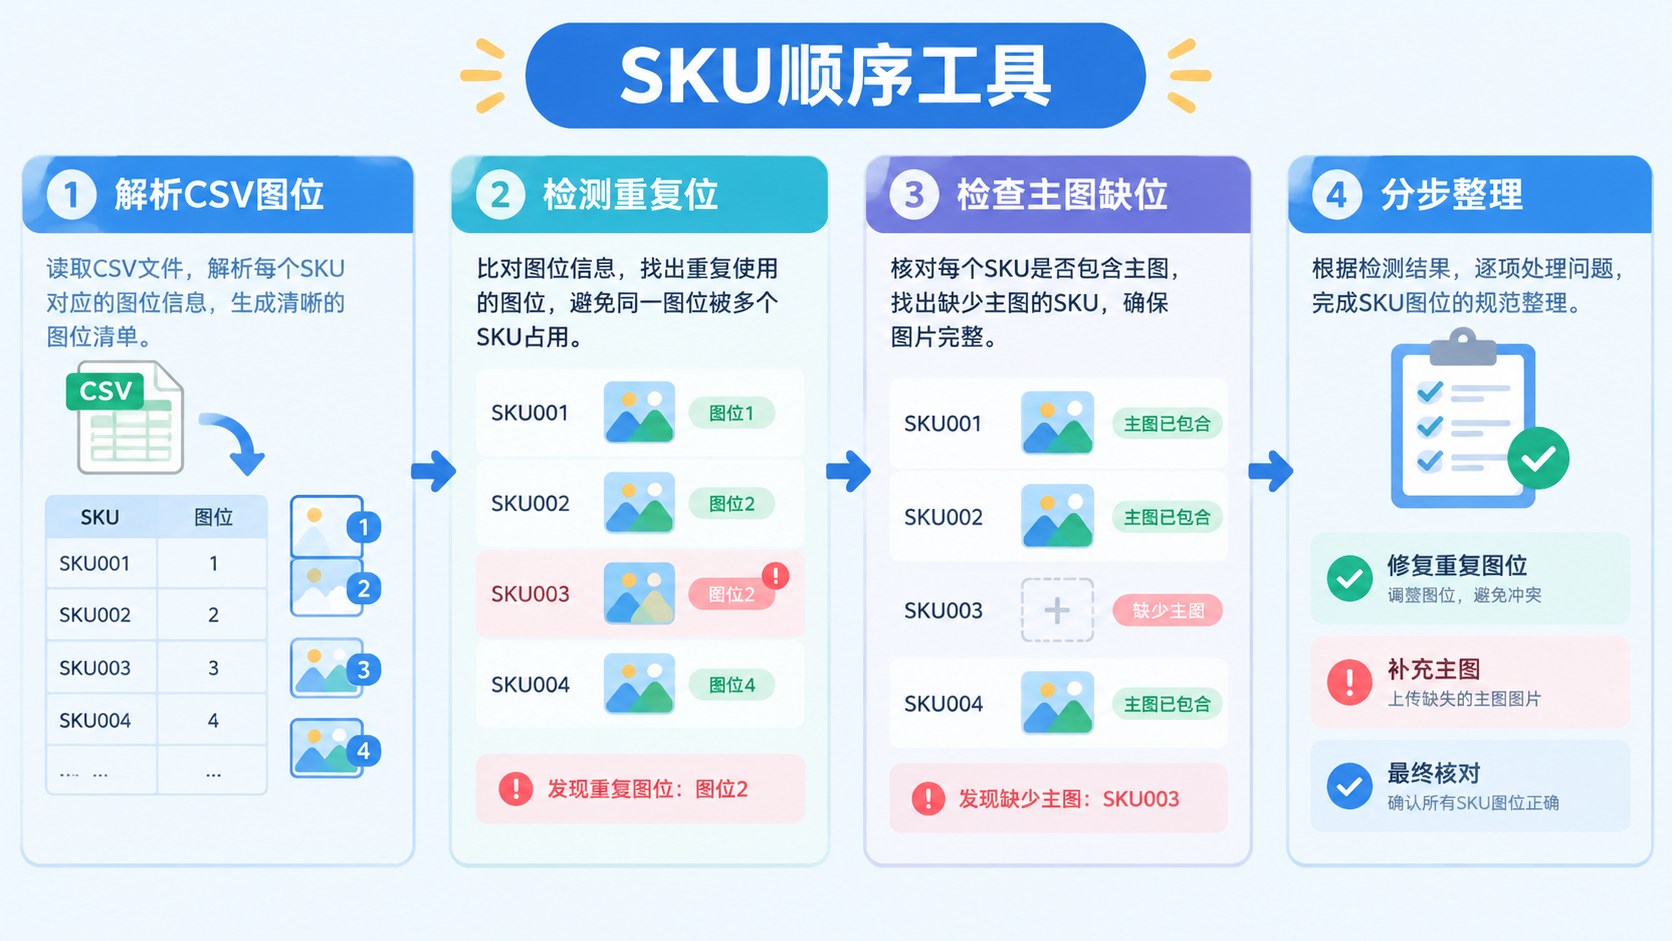
代码把图位序号核对限定成小范围任务,刻意不增加网络请求、文件覆盖和发布动作。
运行结果与排错
成功返回空错误列表;错误夹具同时报告duplicate_position与detail_before_main;零图位抛出position_must_be_positive。
序号算法只说明清单顺序,不读取图像内容,不验证实际上传后的平台顺序。CSV的SKU始终保持字符串,因此001不会变成1。如果要扩大范围,先添加对应失败夹具,再修改实现。
成功分支同样要验证结果含义。
放在图片制作链路的哪里
这个工具适合放在SKU顺序工具相关的本地资料整理环节,和图像制作保持解耦。
实际交接至少保留输入版本、代码版本和完整报告。
本例的覆盖范围是:成功返回空错误列表;错误夹具同时报告duplicate_position与detail_before_main;零图位抛出position_must_be_positive。未覆盖的边界是:序号算法只说明清单顺序,不读取图像内容,不验证实际上传后的平台顺序。CSV的SKU始终保持字符串,因此001不会变成1。
import csv, io, json
def check(text):
    reader = csv.DictReader(io.StringIO(text))
    if not {'sku', 'role', 'position'} <= set(reader.fieldnames or []):
        raise ValueError('missing_columns')
    groups = {}
    for line, row in enumerate(reader, 2):
        sku = row['sku'].strip()
        if not sku or row['role'] not in ('main', 'detail'):
            raise ValueError('invalid_row:' + str(line))
        pos = int(row['position'])
        if pos <= 0:
            raise ValueError('position_must_be_positive')
        groups.setdefault(sku, []).append((pos, row['role']))
    errors = []
    for sku, items in sorted(groups.items()):
        positions = [p for p, _ in items]
        mains = [p for p, role in items if role == 'main']
        if len(set(positions)) != len(positions):
            errors.append([sku, 'duplicate_position'])
        if len(mains) != 1:
            errors.append([sku, 'main_count'])
        elif any(p < mains[0] for p, role in items if role == 'detail'):
            errors.append([sku, 'detail_before_main'])
    return errors
good = 'sku,role,position\n001,main,1\n001,detail,2\n'
bad = 'sku,role,position\n001,detail,1\n001,main,2\n001,detail,2\n'
assert check(good) == []
assert len(check(bad)) == 2
try:
    check('sku,role,position\n001,main,0\n')
except ValueError as exc:
    assert str(exc) == 'position_must_be_positive'
else:
    raise AssertionError('expected rejection')
print(json.dumps({'success': check(good), 'errors': check(bad)}, ensure_ascii=False))
编辑复核与下一组测试
这份检查器的核心不是把CSV按position重新排序,而是判断同一sku的图位安排能否成立。读取报告时应先把duplicate_position与detail_before_main放回同一SKU的全部行中查看:前者说明至少两行争用一个图位,后者说明细节图的序号没有满足主图在前的要求,两项同时出现时不能只把细节图挪到后面就认为问题解决,因为重复序号仍可能保留。定位时可并列记录原行、role及转换后的position,由清单负责人决定哪张图承担main角色、哪条序号需要调整。不要把CSV的物理行顺序当成图位顺序;即使主图写在文件首行,只要其position落在细节图之后,仍不符合本文契约。主图要求是有且只有一张,因此主图缺位和主图重复应作为下一组独立测试,而不是与重复图位混在一个样例里,否则很难判断究竟覆盖了哪条规则。已有零图位抛出position_must_be_positive的分支提醒我们,位置是否合法应先于排序关系解释;位置为零时,不应擅自加一或把它当作未排序图片继续检查。可以再准备负数、非数字字符串以及正整数间有空档的输入,分别确认拒绝范围与序号是否必须连续;本文只要求正整数和先后关系,没有要求把所有图位压成连续编号。对于sku为001的行,交接表中也要保留原字符串,不能与sku为1的行合并检查,否则两个规格各自的主图可能被误报为同一规格的多张主图。另一个值得单独确认的输入是main以外的role写法,新增角色应先说明是否参与细节图比较,不要根据名称自行推断。最适合使用这份报告的交接点是图片角色标注完成、上传清单尚未提交的时候:编辑核对角色,资料整理人员核对序号,随后将确认后的清单交给上传环节。空错误列表表示这些字段满足检查条件,不能据此认定标成main的文件确实是商品主图,也不能认定平台会按同样顺序展示;需要保留文件与角色的对应关系,上传后另行核对实际图位。