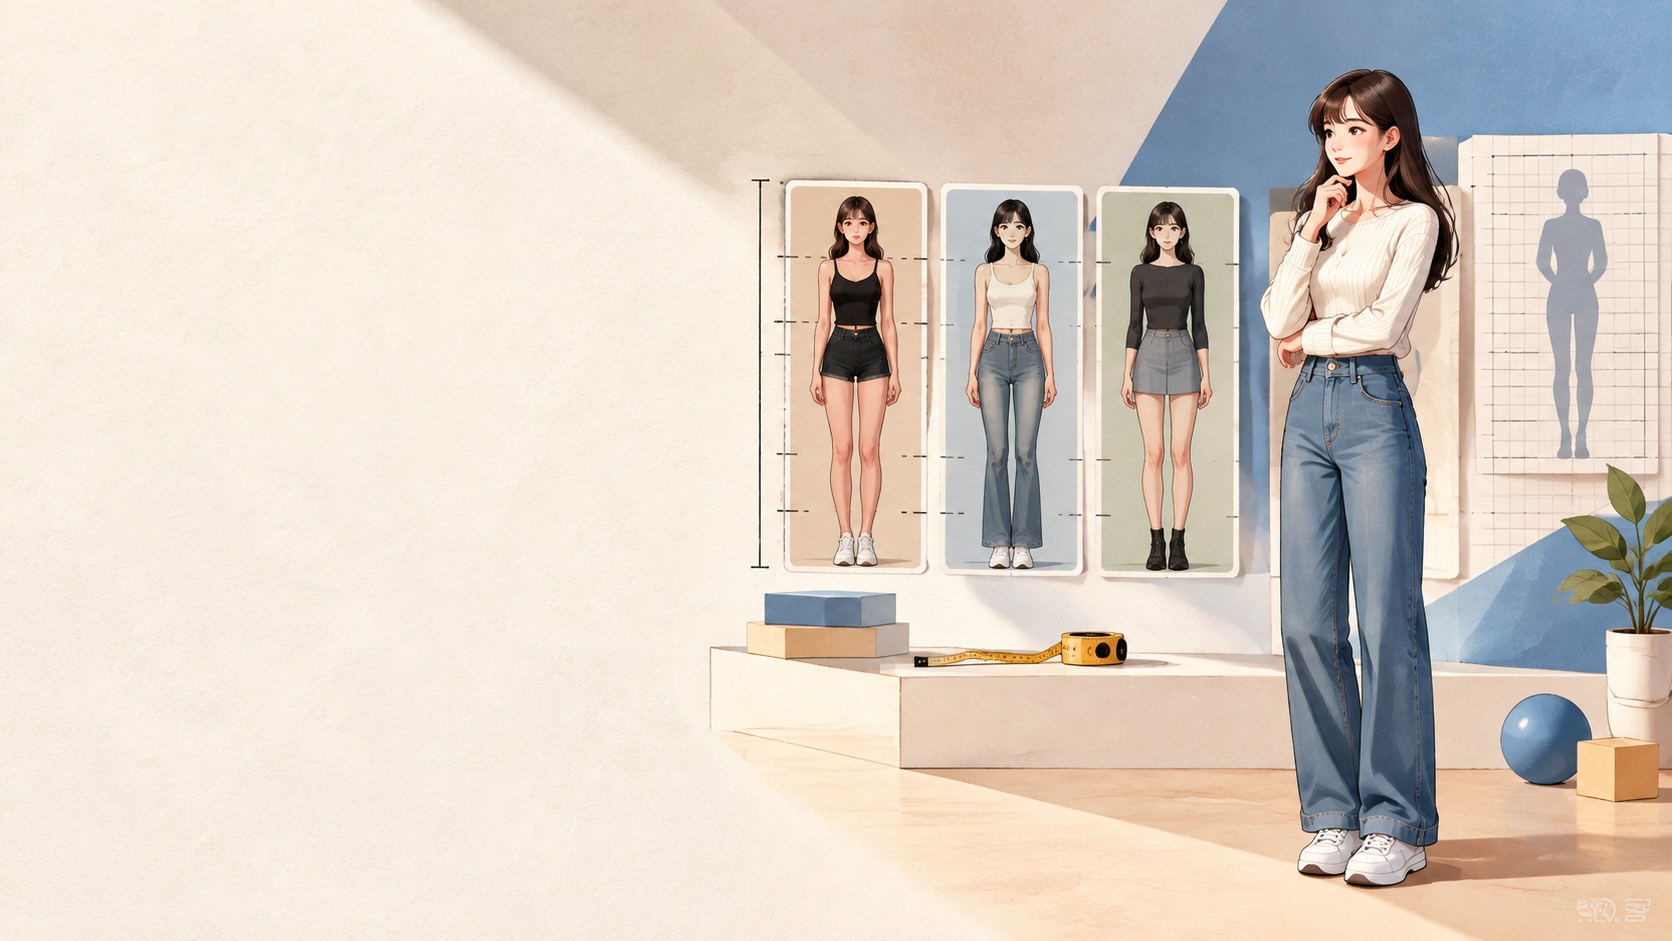
同一件衣服换了模特,一套图可能更难读,是因为观看者失去了稳定的比例参照。讨论“AI套图工具哪个好”,如果对象是服装,不能只比较模特是否好看、场景是否丰富,还要看同一件衣服能否在不同图片中被持续辨认。模特、姿态与镜头同时变化时,衣长、肩线和松量的视觉差异会混在一起,漂亮的图片未必形成清楚的商品说明。
同一件衣服换了模特,一套图可能更难读,是因为观看者失去了稳定的比例参照。讨论“AI套图工具哪个好”,如果对象是服装,不能只比较模特是否好看、场景是否丰富,还要看同一件衣服能否在不同图片中被持续辨认。模特、姿态与镜头同时变化时,衣长、肩线和松量的视觉差异会混在一起,漂亮的图片未必形成清楚的商品说明。
假设一件宽松衬衫有正面、侧面和背面展示,三张图分别换了不同身形的模特。正面看起来刚好盖住臀部,侧面像短款,背面又显得很宽。观看者不知道这是模特身高与比例造成的,还是图片把衣服改了。问题不在于必须使用某种身材,而在于这组图承担的是同一商品的连续观察,却不断更换观察所依赖的条件。
最先值得确认的是服装身份,而不是模特身份。领型、门襟、口袋位置、袖口结构和下摆形状,能帮助人判断是不是同一件衣服。若换模特后口袋随之移动,袖口由扣合变成松紧,或者弧形下摆变成平直,那已经不只是穿着差异。此时应当退回商品原图查结构,不宜用“每个人穿起来都不同”来解释。
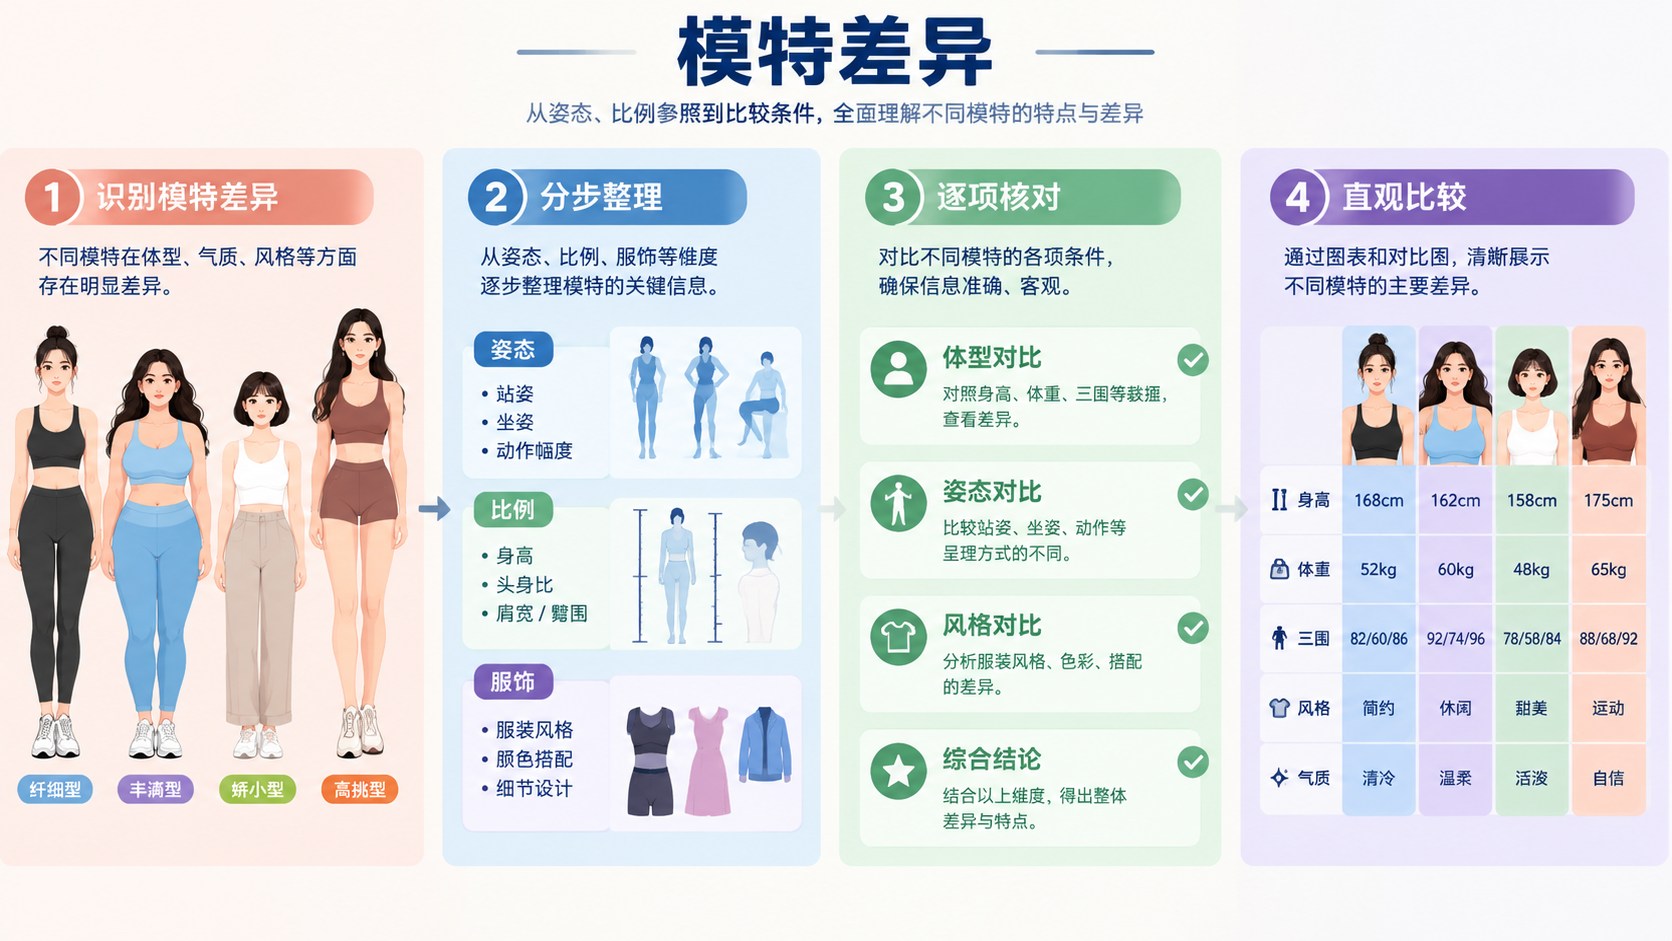
姿态会进一步改变可读性。双臂举起时衣摆被带动,叉腰时侧腰形成褶皱,身体前倾时前片可能缩短。单独看,每张图都有合理的动作;放进同一套图,却不能直接拿来比较衣长和宽松程度。若目的是帮助人理解版型,可以保留一张自然站立、手臂不遮挡侧缝的基准图,再让动作图补充穿搭氛围,而不是替代它。
镜头条件也需要被纳入讨论。低机位可能突出腿部比例,近距离拍摄可能放大靠近镜头的身体部位,宽松袖子在某些角度下又会遮住腰线。观看者通常看不到这些拍摄设置,只能从画面推测。因此,一张正面图的下摆位置和另一张低机位图的下摆位置,并不是天然可比的证据,即使两张都标着相同尺码。
有时候,一套图使用同一个模特,也仍然难读。前一张把衬衫完全塞进裤腰,后一张放下衣摆,第三张外面又加了一件背心,商品的关键轮廓始终不完整。稳定模特只是减少一个变量,不是自动解决所有问题。真正需要稳定的是展示任务:哪张说明自然垂落,哪张说明袖口,哪张展示背部,观看者不应靠猜测来分工。
尺码信息可以帮助解释,但不能承担图像无法完成的全部工作。标注模特身高、所穿尺码与商品尺寸,前提是这些信息有真实依据。即便如此,身高相同也不代表肩宽、躯干长度和穿着习惯相同。更适合的理解是把数据作为参照,把照片作为形态展示,而不是凭一张模特图推断所有身材穿上都会达到同样位置。
如果需要比较不同身形的上身状态,不妨明确把它设计成另一组内容。保留相近站姿和机位,注明各自所穿的实际尺码,让观看者知道这组图在比较穿着条件,而非展示多个商品版本。假设场景中的模特资料没有可靠来源,就不应补写具体身高与身体尺寸来增强说服力。缺失的信息应当留空,不能让数字替图像制造确定性。
判断套图方案是否适合这件衬衫,可以看几个相互独立的结果:不同视角的结构是否对应,基准姿态是否清晰,服装有没有被配饰遮挡,局部图能否回到整件衣服的位置。这些依据比“生成了多少张”更接近购买者的问题。数量可以增加展示机会,也可以增加互相矛盾的画面;不能把图多直接当作更完整。
错误例子是,把每一张都做成不同人物、不同场景、不同动作的穿搭海报,然后要求它们共同说明版型。观看者在第一张认领口,第二张找袖口,第三张却只能看到外套下面的一截衣摆。内容看似丰富,核心信息不断被打断。退回时应该先找出最清楚的一张作为主参照,再删掉无法补充商品信息的画面,而不是继续添加场景。
若某张图特别有吸引力,却与基准图的衣长明显不一致,也没有必要立刻把整组全部否定。可以先定位差异:是不是塞衣方式变了,身体是否转侧,镜头有没有倾斜,还是下摆结构真的被改动。能由真实穿法解释的,应把穿法说清楚;涉及商品结构变化的,就撤回该张。这样的区分比笼统评价“自然”或“不自然”更有用。
同一套图还可以允许信息密度不均匀。基准正面图需要让轮廓完整,细节图只负责袖口或领座,穿搭图则可以保留动作与环境。它们不必都拥有相同构图,但应共享清楚的商品身份。观看者翻到局部时能够认出前面那件衣服,翻到场景时仍能找到关键结构,这种连续性才使不同类型的图片组成一套。
因此,服装套图的好坏最终可以落到一个具体问题:看完之后,人是否更容易区分衣服本来的形态与模特带来的变化。允许人物多样,并不意味着放弃比较条件;追求统一,也不意味着每张都僵硬地站着。把稳定参照留在说明版型的位置,把变化留在展示穿搭的位置,比单独追逐任何一张图的完成度更值得讨论。