批量精修前,程序可以帮助选出覆盖不同图片比例的样本,但不能替你判断材质和商品结构难度。下面用 Node.js 将目录清单分成竖图、近方图和横图,并按文件名稳定抽取;错误尺寸单独返回,不把缺失信息归到某个正常分组。
批量精修前,程序可以帮助选出覆盖不同图片比例的样本,但不能替你判断材质和商品结构难度。下面用 Node.js 将目录清单分成竖图、近方图和横图,并按文件名稳定抽取;错误尺寸单独返回,不把缺失信息归到某个正常分组。
样本选择的目标是让试用覆盖任务差异。杯子、透明瓶和绒面商品虽然都可能是方图,视觉难点并不相同。因此比例分桶只解决输入布局的覆盖,需要在结果上继续补标签密集、反光和边缘复杂的商品。批量精修工具是否支持你的处理动作,还需拿这些真实材料试用。
输入与分桶策略
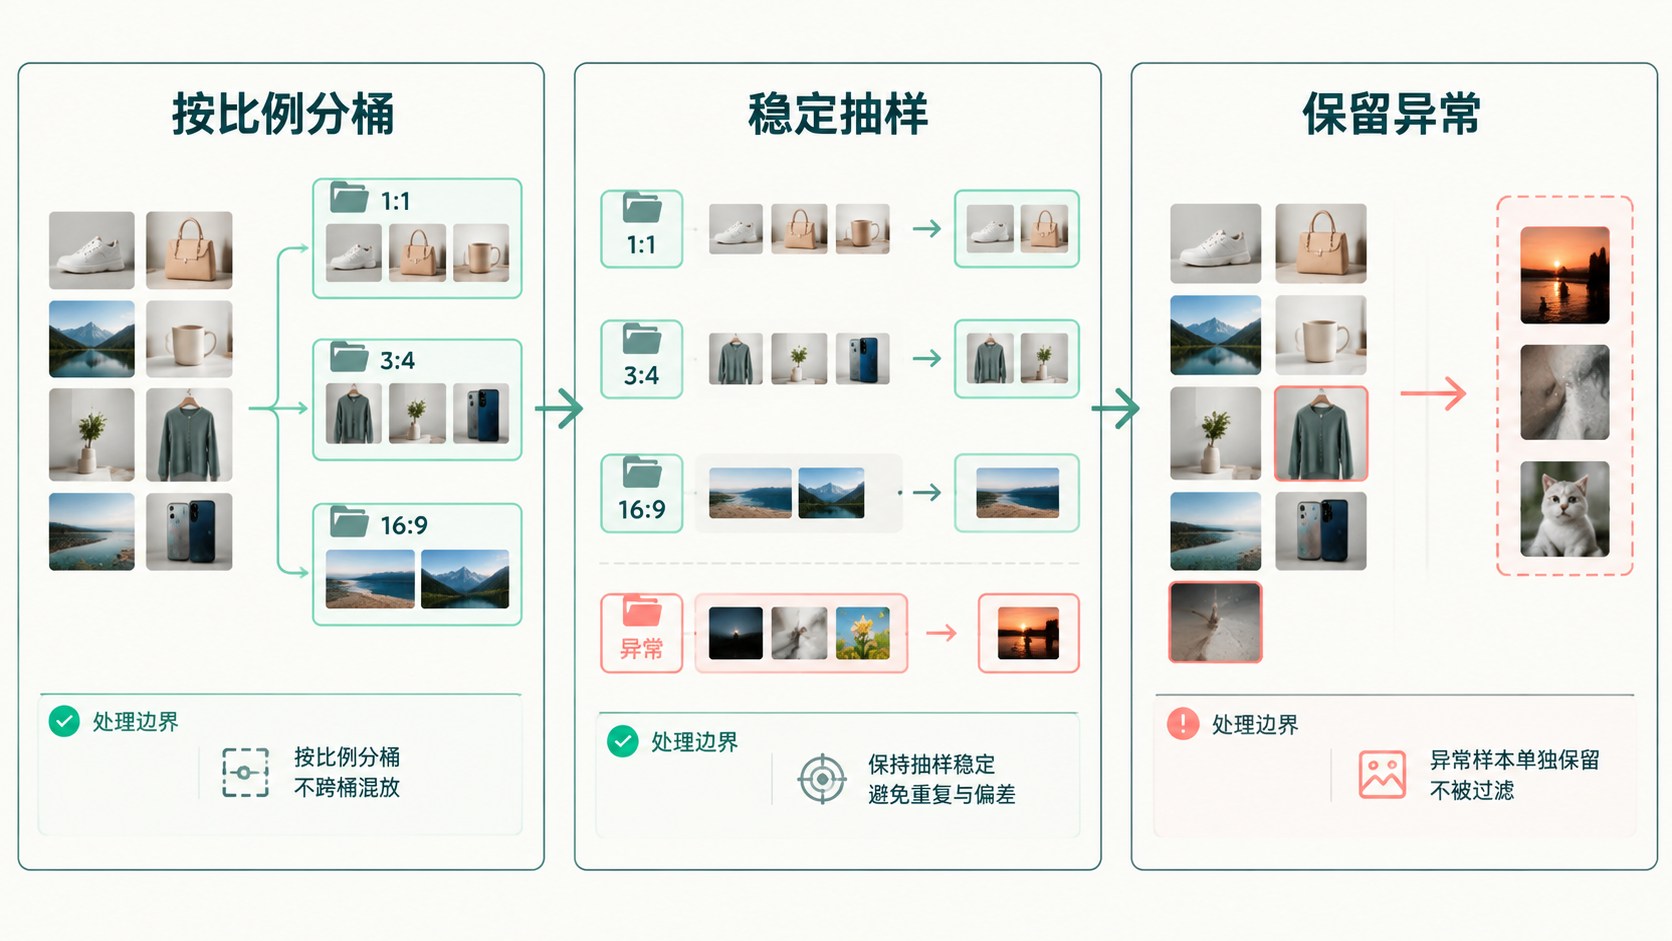
输入是一组含 file、width、height 的对象,可由目录清点生成。宽高必须为有限正数,文件标识必须为字符串;非法记录进入 rejected,不参与抽取。比例小于0.9归竖图,大于1.1归横图,中间归近方图。这两个边界是本文的示例策略,不是平台规范或图像质量标准。
export function pickSamples(rows, perBucket = 1) {
  if (!Number.isInteger(perBucket) || perBucket < 1) throw Error('sample count');
  const buckets = new Map(), rejected = [];
  for (const row of rows) {
    const { file, width: w, height: h } = row;
    if (typeof file !== 'string' || !Number.isFinite(w) || !Number.isFinite(h) || w<=0 || h<=0) {
      rejected.push(row); continue;
    }
    const ratio = w/h;
    const key = ratio < 0.9 ? 'portrait' : ratio > 1.1 ? 'landscape' : 'near-square';
    if (!buckets.has(key)) buckets.set(key, []);
    buckets.get(key).push(row);
  }
  const selected = [];
  for (const [bucket, items] of buckets) {
    items.sort((a,b) => a.file < b.file ? -1 : a.file > b.file ? 1 : 0);
    selected.push(...items.slice(0,perBucket).map(x => ({ ...x, bucket })));
  }
  return { selected, rejected };
}
保存为 samples.mjs,用另一个 .mjs 文件导入 pickSamples,传入清单和每桶数量。程序只处理内存数据,不访问文件、移动图片或调用 AI。每个桶按普通字符串顺序排序再取前几项,可以让相同内容即使输入顺序变化,仍得到相同文件集合;桶输出顺序随首次出现顺序变化。
验证稳定抽取与非法输入
本次构造了横图、竖图、方图与宽度为零的记录。验证结果是三个正常桶各返回一项,非法记录进入 rejected;反转输入后,各桶选出的文件没有变化。另验证每桶数量为零会抛出错误。代码运行于 Node.js v24.16.0,这些结果只说明实现满足所列输入条件,不说明抽样能够代表全部商品风险。
函数不去重文件名,也不处理跨目录身份。业务侧应该在清单建立时确保唯一文件标识,必要时用 SKU 与用途组成稳定键。重复文件和相同商品多角度不能简单视为同一种情况:前者可能是交付错误,后者可能是有意义的样本,需要业务规则判断。
比例覆盖完成后,人工补充复杂样本。比如横图桶挑出的是一个干净纸盒,却没有透明瓶,就将透明瓶作为额外检查项,不改变算法结果来假装自动识别了材质。保留程序抽取与人工追加的来源,下一次试用才知道覆盖条件从哪里来。
对于 Picset 这类公开定位在电商图制作的候选,[1] 可以把抽样清单接在提交素材之前:先查输入比例,再按商品难点补样本。本文没有验证 Picset 内置抽样能力,也没有将算法与某种模型效果绑定。相同流程同样可用于人工修图前的样本准备。
试用记录还需保留第一版、修订原因与最终不可用位置,不能因为三个桶各有一张通过,就将全部图片直接交付。稳定抽取让团队容易复查同一组输入;真实商品样本与逐张基本核对,则负责算法看不到的结构和材质边界。